Echtzeit-Vision-Pipeline für Restaurants auf AWS für Ocumentis
Proof of Concept, der die GPU-basierte Eingangsüberwachung von Ocumentis von einem Server vor Ort auf Amazon EKS verlagert — mit einem GPU-Knoten, der nur während der Öffnungszeiten läuft.
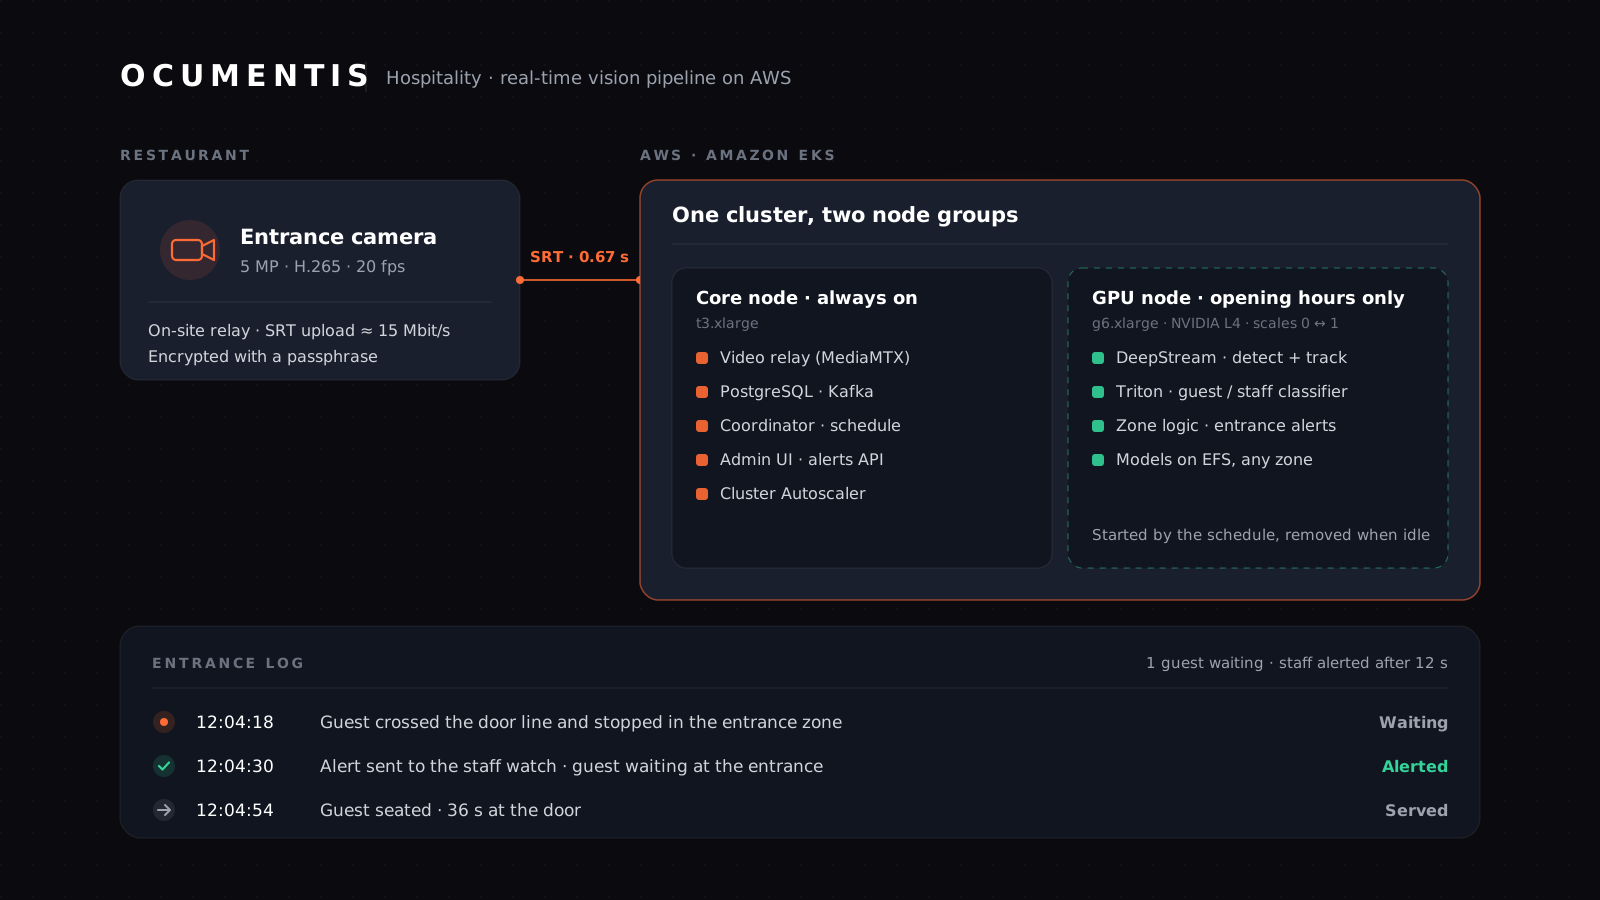
Überblick
Ocumentis macht aus Kameras visuelle KI-Agenten für Gastronomie, Gesundheitswesen und Einzelhandel: Das System beobachtet einen Raum in Echtzeit und benachrichtigt das Personal, wenn etwas Aufmerksamkeit braucht — zum Beispiel ein Gast, der am Restauranteingang wartet. Bisher läuft das Produkt auf einem GPU-Server in jedem Lokal. DataMax hat einen Proof of Concept gebaut, der dieselbe Pipeline mit einer Live-Eingangskamera auf AWS betreibt — um herauszufinden, was eine Cloud-Version kostet, wie das Video dorthin kommt und ob die Erkennungsqualität erhalten bleibt.
Herausforderung
Jedes Restaurant braucht derzeit einen eigenen GPU-Server vor Ort. Für eine Cloud-Version waren drei Fragen offen. Das Kameravideo (5 Megapixel, H.265, rund 15 Mbit/s pro Kamera) muss die Internetverbindung des Lokals zuverlässig und mit geringer Verzögerung überqueren. Die GPU ist der größte Kostenfaktor und sollte nicht rund um die Uhr laufen. Und Erkennung und Uniform-Klassifikator hatten bisher nur Video in voller Qualität aus dem Restaurant gesehen — niemand wusste, wie viel Kompression die Pipeline verträgt.
Vorgehen
Eine Kamera, erst messen, dann entscheiden. Wir haben das Ocumentis-Helm-Chart mit minimalen Änderungen am Code auf Amazon EKS ausgerollt, den Videotransport durch einen SRT-Stream in ein kleines Relay im Cluster ersetzt und ein Testlabor gebaut, das aufgezeichnete Eingangsaufnahmen über eine simulierte Internetanbindung des Lokals mit verschiedenen Geschwindigkeiten, Auflösungen und Bitraten abspielt. Jeder Durchlauf erfasste Übertragungsverzögerung, Frame-Verluste und ob Gäste und Personal an der Tür korrekt erkannt wurden.
Lösung
Der Cluster hat zwei Node-Gruppen: einen kleinen, dauerhaft laufenden Knoten für Datenbank, Kafka, Coordinator und Admin-UI sowie einen GPU-Knoten (NVIDIA L4), den der Cluster Autoscaler nur startet, solange die Pipeline laut Zeitplan laufen soll — passend zu den Öffnungszeiten des Restaurants. Das Video kommt per SRT über einen Network Load Balancer an, mit Passphrase verschlüsselt, und ein MediaMTX-Relay reicht es per RTSP an DeepStream weiter — mit einem Schwarzbild-Fallback, damit eine abgebrochene Verbindung die Pipeline nie stoppt. Die Modelle liegen auf EFS, sodass der GPU-Knoten in beiden Availability Zones starten kann; Anwendungsdaten liegen auf EBS, Secrets kommen aus AWS Secrets Manager und Images aus ECR. Das Setup ist Schritt für Schritt dokumentiert, damit Ocumentis es in jedem Account nachbauen kann.
Ergebnisse
Bereit, Ihre KI-Reise zu beschleunigen?
Lassen Sie uns über Ihre Daten- und KI-Herausforderungen sprechen. Wir helfen bei Strategie und schneller Umsetzung.
Kontakt aufnehmen